Μια μηχανή απαντήσεων χρησιμοποιεί δύο πηγές για να μιλήσει για την επιχείρησή σας: όσα έμαθε το γλωσσικό της μοντέλο κατά την εκπαίδευση και όσες σελίδες ανακτά από το web τη στιγμή της ερώτησης. Την πρώτη δεν τη ρυθμίζετε εσείς και δεν αλλάζει άμεσα. Τη δεύτερη μπορείτε να την επηρεάσετε, γιατί εξαρτάται από το αν η σελίδα σας βρίσκεται, διαβάζεται και χρησιμοποιείται ως πηγή.
Εδώ βρίσκεται και η βασική διαφορά από το SEO. Στο SEO ανταγωνίζεστε για θέση σε μια λίστα αποτελεσμάτων. Εδώ ανταγωνίζεστε για το αν θα χρησιμοποιηθεί το περιεχόμενό σας μέσα σε μια απάντηση που γράφεται από την αρχή.
Τι σημαίνει «μνήμη του μοντέλου»;
Ένα γλωσσικό μοντέλο (large language model, LLM) εκπαιδεύεται σε μεγάλες συλλογές κειμένων και μαθαίνει στατιστικά πώς συνδέονται οι λέξεις και οι έννοιες. Δεν αποθηκεύει σελίδες όπως ένας κατάλογος. Παράγει κείμενο που ταιριάζει με όσα έχει μάθει.
Η γνώση αυτή έχει ημερομηνία λήξης, την ημερομηνία αποκοπής της εκπαίδευσης. Ό,τι άλλαξε μετά, όπως νέες υπηρεσίες, νέα διεύθυνση ή νέα τιμολόγηση, το μοντέλο δεν το ξέρει από μόνο του. Όταν απαντά μόνο από μνήμη για μια μικρή τοπική επιχείρηση, μπορεί να δώσει ελλιπή ή λανθασμένη εικόνα με πειστικό ύφος. Αυτό λέγεται «παραίσθηση» (hallucination).
Πότε η μηχανή ψάχνει στο web;
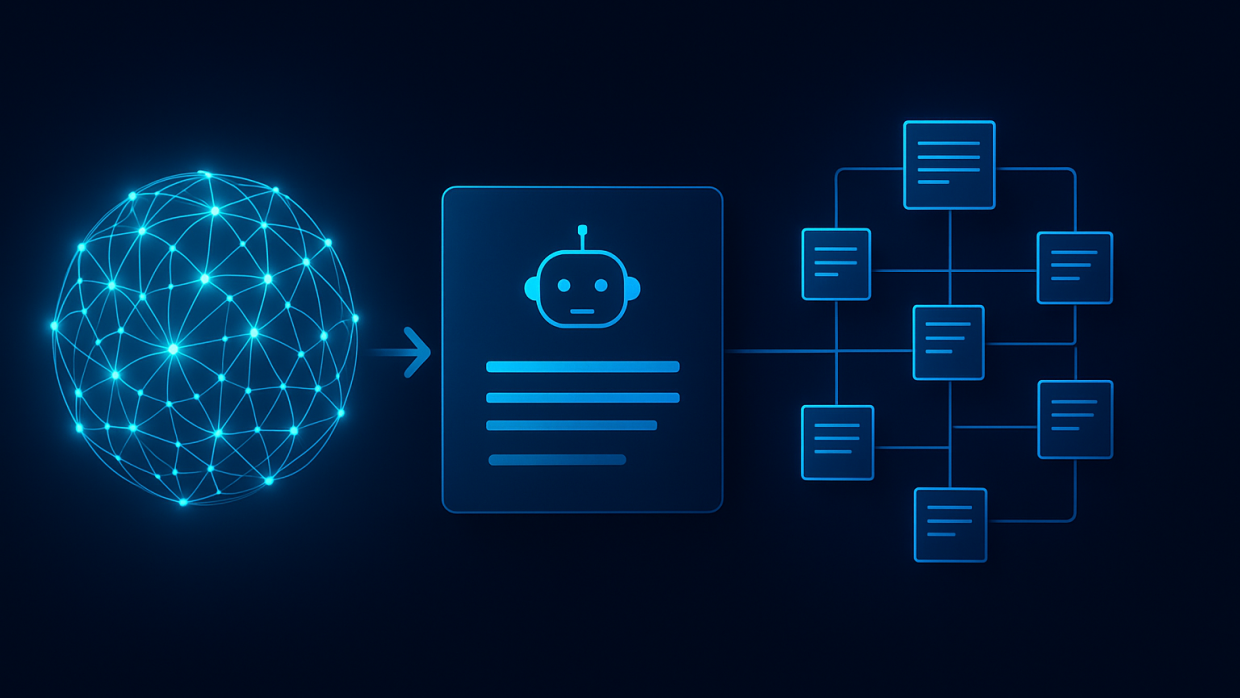
Όταν το προϊόν είναι συνδεδεμένο με αναζήτηση, η μηχανή μπορεί να ανακτήσει σελίδες πριν απαντήσει. Η τεχνική λέγεται retrieval-augmented generation (RAG), δηλαδή παραγωγή απάντησης ενισχυμένη με ανάκτηση πηγών. Το μοντέλο διαβάζει αποσπάσματα από τις σελίδες που βρήκε και συνθέτει την απάντηση πάνω σε αυτά.
Στο Perplexity η αναζήτηση στο web είναι το κεντρικό χαρακτηριστικό και οι πηγές εμφανίζονται δίπλα στην απάντηση. Στο ChatGPT υπάρχει λειτουργία αναζήτησης που ενεργοποιείται όταν το σύστημα το κρίνει απαραίτητο ή όταν την επιλέγει ο χρήστης. Στα AI Overviews της Google και στο Gemini η απάντηση στηρίζεται σε συνδυασμό του μοντέλου με την αναζήτηση της Google. Οι λεπτομέρειες κάθε προϊόντος αλλάζουν συχνά, γι’ αυτό ελέγχετε την τρέχουσα τεκμηρίωση του κάθε παρόχου.
Πώς γίνεται η απάντηση βήμα βήμα;
Η ακριβής εσωτερική λειτουργία διαφέρει ανά πάροχο και δεν είναι δημόσια σε όλες τις λεπτομέρειες. Η γενική διαδρομή, όπως την περιγράφουν οι ίδιοι οι πάροχοι, έχει αυτά τα στάδια:
- Κατανόηση της ερώτησης: το σύστημα αποφασίζει τι ζητά ο χρήστης και αν αρκεί η μνήμη του μοντέλου.
- Αναζήτηση: αν χρειάζεται, διατυπώνει ένα ή περισσότερα ερωτήματα προς ένα ευρετήριο σελίδων.
- Επιλογή πηγών: από τα αποτελέσματα κρατά σελίδες που φαίνονται σχετικές και αξιόπιστες.
- Εξαγωγή αποσπασμάτων: διαβάζει τα σημεία των σελίδων που απαντούν στην ερώτηση.
- Σύνθεση: γράφει την απάντηση και, σε πολλά προϊόντα, προσθέτει παραπομπές στις πηγές.
Η σελίδα σας μπορεί να αποτύχει σε οποιοδήποτε στάδιο. Μπορεί να μη βρεθεί, να μη διαβαστεί σωστά ή να μη δίνει καθαρή απάντηση που αξίζει να παρατεθεί.
Τι διαφέρει αυτό από το SEO;
Το αποτέλεσμα του SEO είναι μια κατάταξη: η σελίδα σας εμφανίζεται πρώτη, δεύτερη ή δέκατη και ο χρήστης επιλέγει. Το αποτέλεσμα μιας μηχανής απαντήσεων είναι ένα κείμενο που ο χρήστης διαβάζει χωρίς να ανοίξει καμία σελίδα. Η επιχείρησή σας είτε αναφέρεται μέσα σε αυτό είτε όχι.
Αλλάζει και η μονάδα που ανταγωνίζεται. Στο SEO ανταγωνίζεται ολόκληρη η σελίδα. Εδώ ανταγωνίζεται το απόσπασμα, δηλαδή μια παράγραφος ή μια λίστα που απαντά από μόνη της σε μια ερώτηση. Γι’ αυτό οι σαφείς προτάσεις, οι ξεκάθαρες επικεφαλίδες και τα πραγματικά στοιχεία της επιχείρησης (τι προσφέρετε, πού, για ποιον) έχουν μεγαλύτερη αξία από το φούσκωμα με λέξεις-κλειδιά.
Πολλά από όσα ξέρετε από το SEO εξακολουθούν να ισχύουν. Μια σελίδα που δεν μπορεί να ανακτηθεί από ένα ευρετήριο δύσκολα θα χρησιμοποιηθεί ως πηγή. Οι ακριβείς μηχανισμοί επιλογής πηγών από κάθε μηχανή όμως δεν είναι πλήρως γνωστοί, και όποιος υπόσχεται σίγουρη σειρά ή σίγουρη παράθεση προχωρά πέρα από όσα ξέρουμε.
Ποιοι crawlers πρέπει να έχουν πρόσβαση στη σελίδα σας;
Ένας crawler είναι ένα πρόγραμμα που επισκέπτεται σελίδες αυτόματα. Οι εταιρείες AI χρησιμοποιούν διαφορετικούς crawlers για διαφορετικούς σκοπούς, και το αρχείο robots.txt σάς επιτρέπει να τους ρυθμίσετε ξεχωριστά.
Η OpenAI, για παράδειγμα, τεκμηριώνει δημόσια τρεις: τον GPTBot, που σχετίζεται με τη συλλογή δεδομένων για εκπαίδευση, τον OAI-SearchBot, που σχετίζεται με τα αποτελέσματα αναζήτησης του ChatGPT, και τον ChatGPT-User, που χρησιμοποιείται όταν ο χρήστης ζητά ενέργεια μέσα στο προϊόν. Το Perplexity τεκμηριώνει τον δικό του PerplexityBot. Αν μπλοκάρετε όλους χωρίς διάκριση, μπλοκάρετε και τη διαδρομή της ανάκτησης. Η απόφαση αν θα επιτρέψετε την εκπαίδευση είναι ξεχωριστή από την απόφαση αν θέλετε να παραθέτεστε στις απαντήσεις, και την παίρνετε εσείς.
Πώς καταλαβαίνετε ποια διαδρομή δουλεύει για την επιχείρησή σας;
Δοκιμάστε το χειροκίνητα, με τις ερωτήσεις που θα έκανε ένας πελάτης σας. Ρωτήστε μια μηχανή χωρίς ενεργή αναζήτηση και δείτε τι «ξέρει» από μνήμη. Ρωτήστε την ίδια ερώτηση με αναζήτηση και δείτε ποιες πηγές εμφανίζονται και αν είστε ανάμεσά τους.
- Αν η μηχανή δεν σας γνωρίζει καθόλου και χωρίς αναζήτηση, η μνήμη του μοντέλου δεν θα βοηθήσει και μετράει η ανάκτηση.
- Αν σας γνωρίζει αλλά με παλιά ή λάθος στοιχεία, η μνήμη του μοντέλου υστερεί, και η ανάκτηση από ενημερωμένες σελίδες είναι ο τρόπος διόρθωσης.
- Αν η αναζήτηση φέρνει πηγές τρίτων αντί για τη δική σας, δείτε ποιες είναι: καταλόγους, άρθρα, κριτικές. Αυτές οι σελίδες διαμορφώνουν την εικόνα σας, όπως και η δική σας.
Οι απαντήσεις αυτών των εργαλείων μπορεί να αλλάζουν από ερώτηση σε ερώτηση, ακόμη και για την ίδια διατύπωση. Μία δοκιμή δεν αποδεικνύει τίποτα. Μια σειρά επαναλήψεων με καταγραφή δείχνει πιο καθαρά τη γενική τάση.
Ποιο είναι το πρακτικό επόμενο βήμα;
Ανοίξτε το robots.txt του ιστότοπού σας και ελέγξτε ότι δεν μπλοκάρετε από λάθος τους crawlers αναζήτησης. Έπειτα γράψτε πέντε ερωτήσεις που θα έκανε πραγματικός πελάτης, δοκιμάστε τες σε ChatGPT, Perplexity και Gemini με και χωρίς αναζήτηση, και καταγράψτε ποιες πηγές εμφανίζονται και τι λέγεται για εσάς. Από αυτή την καταγραφή θα φανεί αν το κενό βρίσκεται στην πρόσβαση, στο περιεχόμενο ή στις πηγές τρίτων.